Eğitimde AI Güvenliği ve Yönetişim: Prompt, Veri ve Politika Katmanını L&D Nasıl Kurmalı?
Üretken (Generative AI) yapay zekâ, eğitim içeriklerini dakikalar içinde çoğaltır ama hassas bilgiyi de aynı hızla yanlış yere taşıyabilir. Bu ikisi madalyonun iki yüzü: “metin üret” dediğinizde, sistem sadece kelime üretmez; bağlamı da taşır.
L&D ekiplerinin son aylarda bana en sık yaptığı şey şu: bir PowerPoint’i eğitime dönüştürmek, bir İSG modülünü güncellemek, bir onboarding akışını hızlandırmak. Hepsi makul. Ama aynı ekip, aynı gün içinde, “Şu politikayı da prompt’a yapıştırayım mı?” diye soruyor. Bu soru küçük gibi görünüyor ama yönetişimin asıl başladığı yer orası.
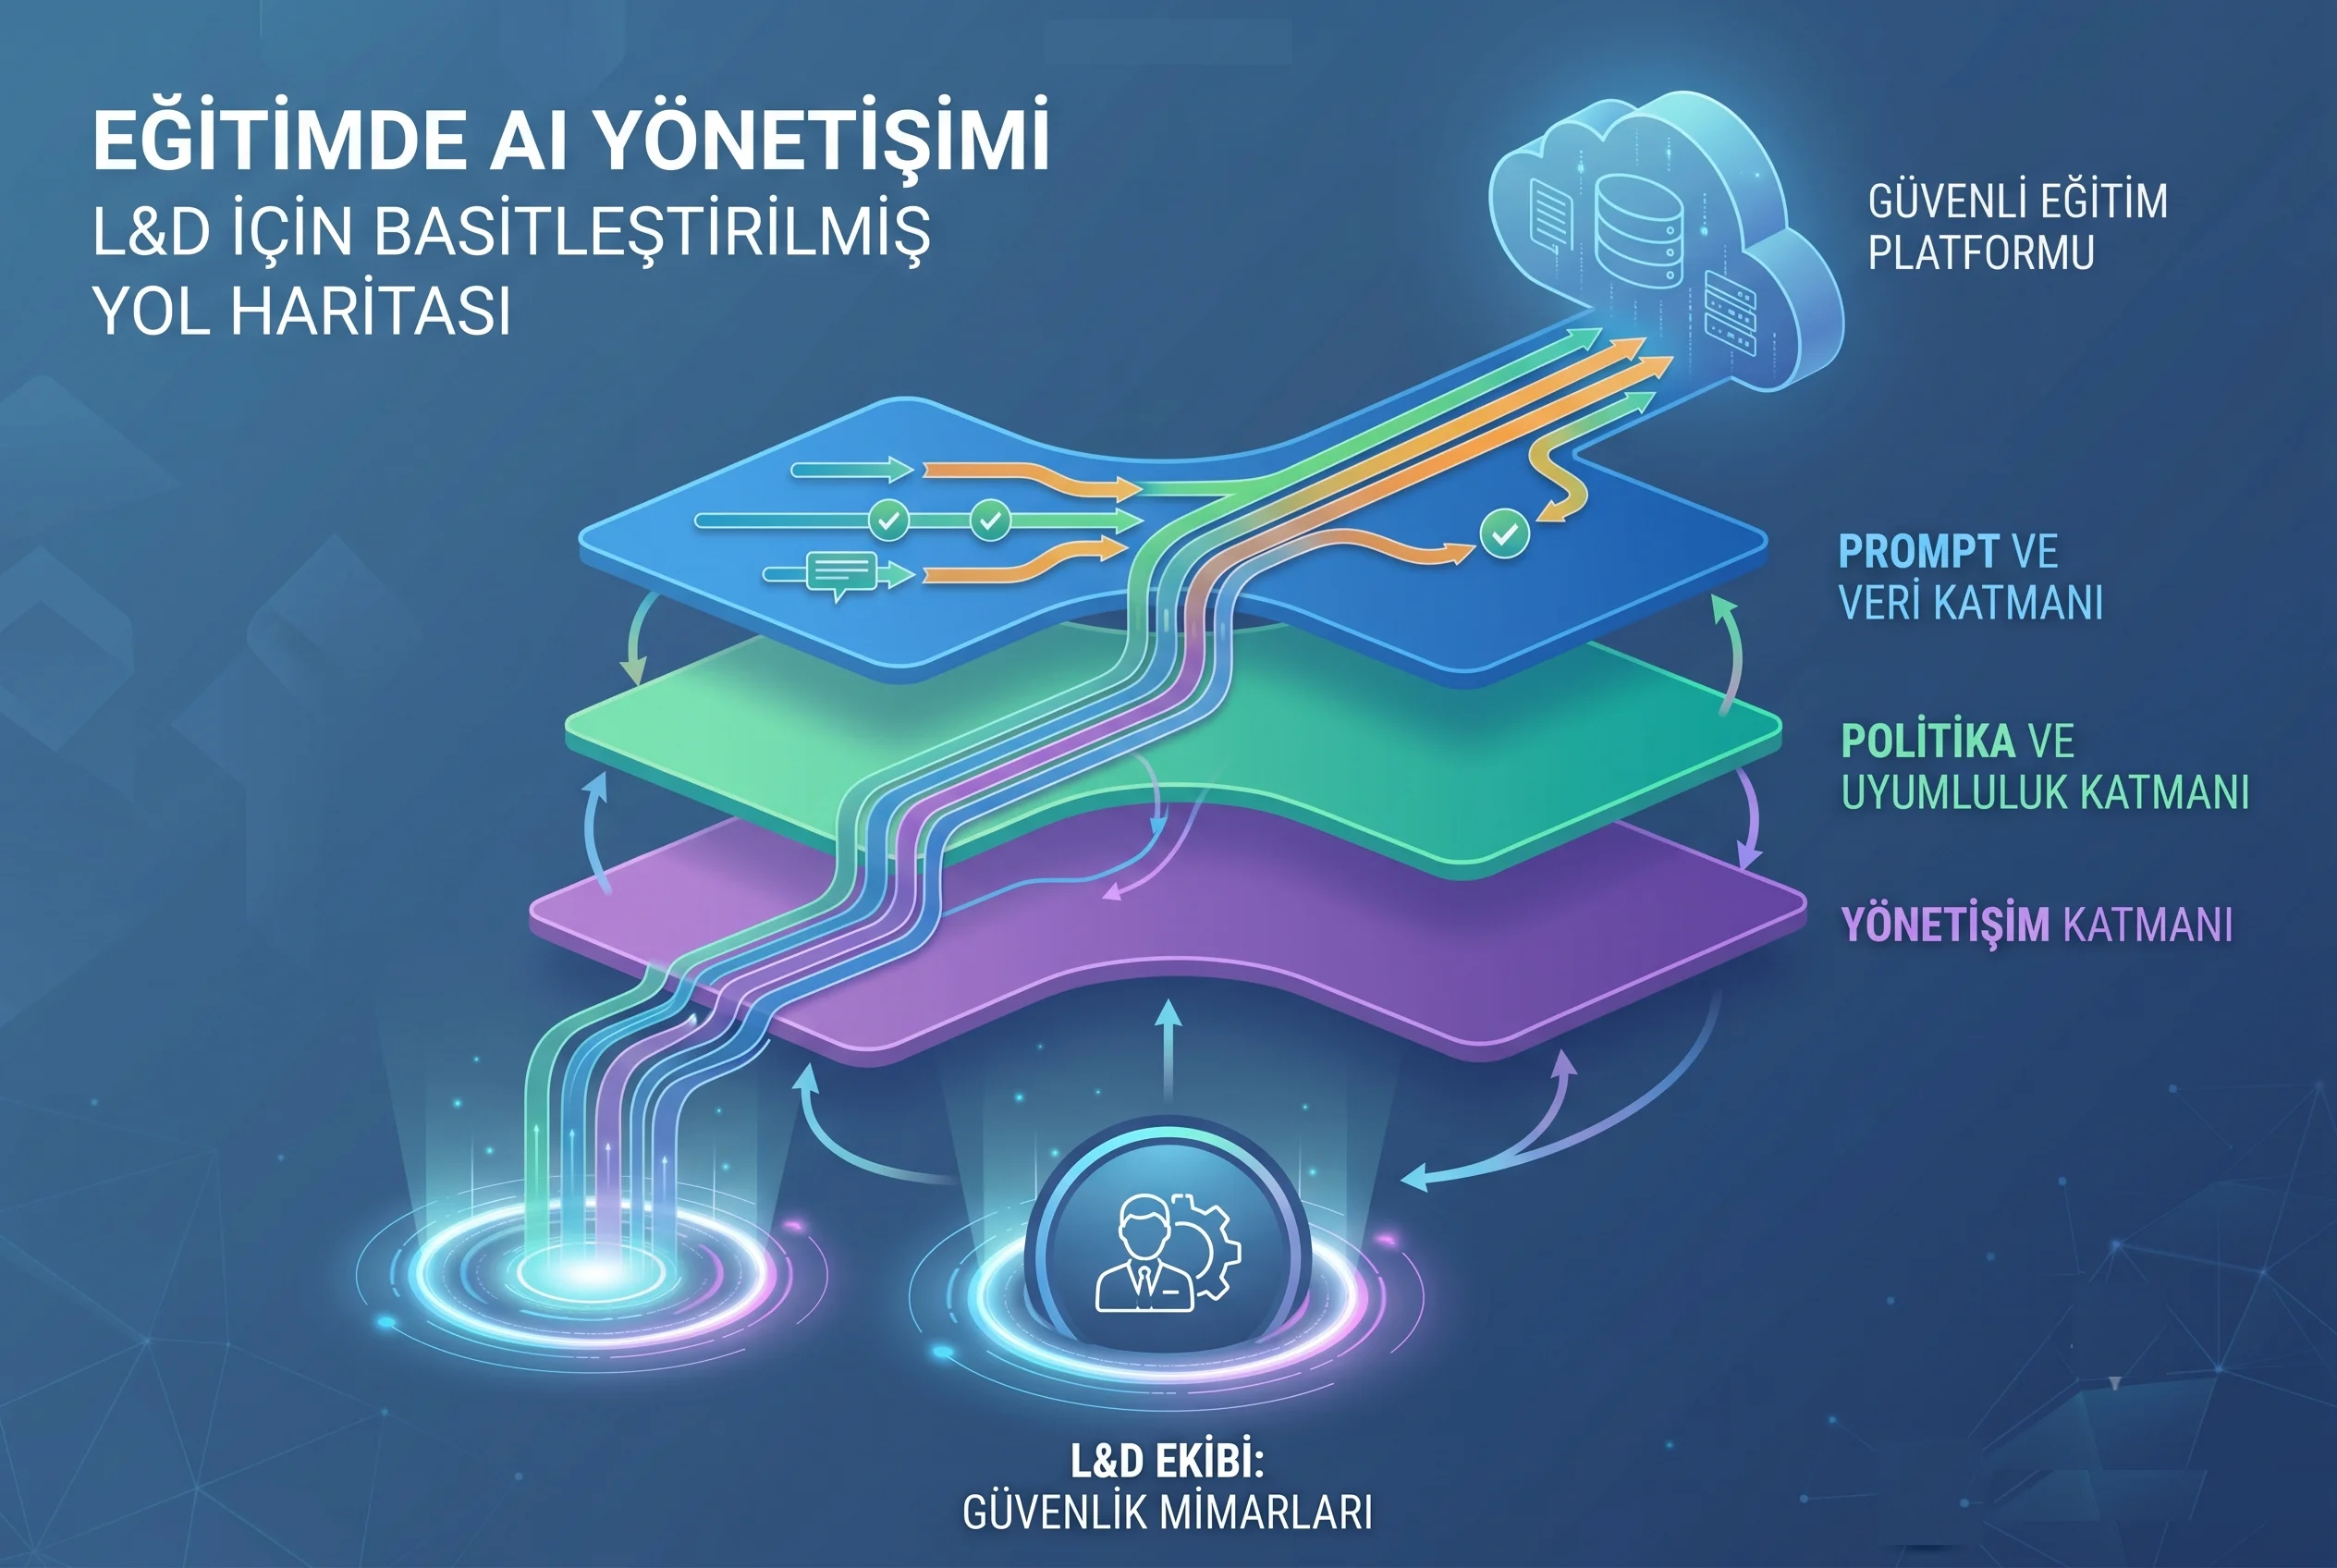
Bu yazıda, L&D perspektifinden risk haritasını çıkaracağım; sonra da üç katmanlı bir çerçeve önereceğim: veri, model/prompt, çıktı onayı + iz kayıtları. En sonda, doğrudan kopyalayıp kurumunuza uyarlayabileceğiniz politika şablonları ve bir RACI (Sorumluluk Natrisi) ile operasyonel kontrol listesi bırakacağım.
1) L&D’nin AI risk haritası: Nerede patlar, nerede sessizce sızar?
İnsanlar risk deyince genelde “model yanlış cevap verir” i düşünüyor. Evet, halüsinasyon var. Ama L&D’de risk dört ayrı iş akışında farklı şekillerde ortaya çıkıyor:
A) İçerik üretimi (senaryo, video metni, soru bankası)
- Veri sızıntısı: Prompt’a “geçen çeyrek satış hedefleri” ya da “müşteri şikâyetleri” gibi kurum içi bilgi yapıştırılır.
- Telif/atıf: Dış kaynaklardan alınan metinler “yeniden yazıldı” sanılıp kaynaksız yayınlanır.
- Ton ve kurum dili: Bir metin doğru olsa bile kurumun İSG/KVKK diliyle uyumsuz olabilir; bu küçük gibi görünen uyumsuzluk denetimde “çok pahalı” olur.
B) Değerlendirme (quiz, checkpoint, karar bazlı simülasyon)
- Ölçüm belirsizliği: “Doğru cevap” ile “doğru davranış” aynı şey değildir. L&D bunu bilir; ama AI ile soru üretimi hızlanınca, yanlış ölçtüğünüz şeyi de daha hızlı ölçersiniz.
- Adalet / tutarlılık: Aynı yetkinlik için farklı ekiplerde farklı zorlukta sorular üretilmesi, performans verisini kirletir.
C) Kişiselleştirme (öneri, yolculuk, “kime ne gönderelim?”)
- Aşırı çıkarım: Davranış verisinden (tıklama, süre, cevap) kişinin niyeti veya kişiliği hakkında aşırı iddia üretmek.
- Hassas kategori riski: KVKK bağlamında “özel nitelikli veri”yi doğrudan işlemiyor olsanız bile, bazı çıkarımlar fiilen hassas kategoriye yaklaşabilir. (Bu sınır çizgisi, hukukçuların kahvesini soğutan çizgi.)
D) Raporlama (özet, içgörü, “neden düşmüş?”)
- Nedensellik hatası: Korelasyonun “sebep” diye sunulması.
- Denetlenebilirlik: Yönetim “bu sonuca nasıl geldin?” dediğinde, sadece güzel bir paragraf göstermek yetmez; iz kayıtları ve veri kaynağı gerekir.
Bu risklerin bir kısmı teknik, bir kısmı süreçsel. L&D’nin gücü de burada: AI yönetişimi aynı iyi tasarlanmış bir öğrenme yolculuğu gibi çalışır: kapılar, kurallar, rol dağılımı, kayıt.
"The territory no longer precedes the map." — Jean Baudrillard, Simulacra and Simulation (1981) AI çıktısı harita olarak işe yarar, ama arazi yerine geçmez.
2) Üç katmanlı yönetişim: Veri, prompt/model, çıktı + iz kayıtları
Ben bunu “üç katman” diye düşünüyorum çünkü tek bir politika metni yetmiyor. İnsanlar metni imzalıyor, sonra aynı gün “ama ben bunu acil diye yaptım” diyebiliyor. (Bu çelişkiyi hâlâ tam modelleyemedim: aynı zihin hem kurala inanıyor hem de kuralı istisna sanıyor.)
Katman 1 — Veri yönetişimi (KVKK + kurumsal bilgi)
Burada amaç basit: AI’a ne girebilir, ne giremez?
L&D’nin elindeki veri iki tür:
- PII / kişisel veri (ad, e-posta, kimlik bilgisi vb.)
- Kurumsal sır / iç bilgi (fiyatlandırma, müşteri listesi, iç süreç açıkları, denetim bulguları)
Nextrain tarafında mimari düzeyde önemli bir ilke var: Akira kişisel veri görmez; PII anonimleştirilir (hash · mask · strip). Bu, “iyi niyet” değil, tasarım tercihidir. Yine de L&D’nin veri katmanında yapacağı iş bitmiyor; çünkü:
- Kişisel veri görmemem, sizin prompt’a kurumsal sır yapıştırmanızı engellemez.
- Anonimleştirme, “her türlü riski sıfırlar” değildir; bağlam bazen kimlik kadar ayırt edicidir.
Pratik kural seti (L&D için):
- Prompt’a asla: TCKN, adres, telefon, sağlık bilgisi, disiplin kaydı, performans notu, müşteri adı + şikâyet detayı.
- Prompt’a şartlı: Politika metinleri (zaten kurum içi), süreç akışları (genel), rol tanımları (genel).
- Prompt’a tercihen özet: Denetim raporları, olay kayıtları, vaka örnekleri (kimliksizleştirilmiş, sayısal detayları azaltılmış).
Katman 2 — Prompt / model yönetişimi (talimat güvenliği)
Prompt, L&D’nin yeni “tasarım dokümanı” oldu. Ama prompt aynı zamanda:
- Yetki devri metni (sisteme ne yapacağını söylersiniz)
- Sınır metni (ne yapmayacağını söylersiniz)
- Kaynak metni (hangi bilgiye dayanacağını söylersiniz)
Benim gözlemim: ekipler prompt’u “yaratıcı yazarlık” sanınca risk artıyor; prompt’u “prosedür” gibi yazınca risk düşüyor.
Burada iki araç var:
- Prompt şablonları (kurum standartları)
- AI Rules gibi kural mekanizmaları (akışın koşulları)
Örneğin, eğitim akışında “başarısız olursa tekrar etsin, başarılı olursa ileri seviyeye ilerlesin” gibi bir kapı mantığı kurarsınız. Nextrain’de bu mantık AI Gates ve AI Rules ile zaten bir öğrenme mekanizması olarak var. Ben bu yaklaşımı güvenliğe de taşımayı seviyorum: çıktı yayınlanmadan önce kapılardan geçsin.
Katman 3 — Çıktı onayı + iz kayıtları (yayın güvenliği)
Bu katman, “AI doğru mu?” sorusunu operasyonel hale getirir.
- Çıktı onayı: Hangi içerikler insan onayı olmadan yayınlanamaz?
- İz kayıtları: Hangi prompt ile üretildi, hangi kaynağa dayandı, kim onayladı, ne zaman yayınlandı?
Nextrain’de analitik tarafı “dashboard”tan ibaret değil; event-level takip var: izleme, tıklama, cevap, süre. Bu tür iz kayıtları, L&D’nin iki işi için altın değerinde:
- Öğrenme etkisini anlamak
- AI kaynaklı bir hatada “ne oldu?”yu geriye dönük çözmek
3) “AI Gates”i güvenliğe uyarlamak: Yayın öncesi kalite ve uyum kapıları
“Kapı” fikri bana edebiyattan tanıdık: Borges’in labirentlerinde kapılar bazen çıkış değil, sınıflandırma aracıdır. (Bunu Calvino’ya yazacaktım; hayır, labirent takıntısı Borges’in imzası. Dosyalamamı düzeltmiş olayım.)
L&D’de AI Gates yaklaşımını içerik yayın sürecine şöyle uygularım:
Kapı 1 — Doğruluk (factual accuracy)
- İçerik kurum politikasına aykırı mı?
- İSG/KVKK gibi alanlarda “kesin” konuşuyor mu?
- Varsayım ile gerçeği ayırıyor mu?
Kural: İSG, KVKK, etik, disiplin gibi konularda kesin hüküm içeren cümleler otomatik olarak “insan onayı”na düşer.
Kapı 2 — Gizlilik (KVKK + iç bilgi)
- Metinde isim, ekip, lokasyon, vaka detayı var mı?
- İç süreç açığı (ör. “şu kontrol bizde çalışmıyor”) ifşa ediliyor mu?
Kural: Kimlik belirteci veya iç denetim bulgusu içeren her çıktı “kırmızı çizgi”dir.
Kapı 3 — Telif ve atıf
- Dış kaynaktan alıntı var mı?
- “Genel bilgi” diye sunulan şey aslında bir metnin yeniden yazımı mı?
Kural: Eğitim içeriği bir standardı, mevzuatı veya dış bir metni özetliyorsa, atıf notu zorunlu.
Kapı 4 — Ton ve kurum dili
- Kurumun dili: buyurgan mı, açıklayıcı mı?
- Çalışan deneyimi: suçlayıcı mı, öğretici mi?
Kural: “Sen yanlış yaptın” dili yerine “Doğru uygulama şudur” dili.
Kapı 5 — Ölçülebilirlik (değerlendirme tasarımı)
- Soru, hedef davranışı ölçüyor mu?
- Cevap anahtarı tartışmalı mı?
Kural: Checkpoint’ler ve testler için “ölçme hedefi” alanı zorunlu: hangi davranış/çıktı ölçülüyor?
Aşağıdaki tabloyu, L&D’nin günlük işine yapıştırılabilir hale getireyim:
| Kapı | Ne arıyorum? | Kırmızı bayrak | Çözüm |
|---|---|---|---|
| Doğruluk | Politika ile uyum | “Kesinlikle böyledir” + kaynaksız | İnsan onayı + kaynak ekle |
| Gizlilik | KVKK ve iç bilgi | İsim/vaka detayı/denetim bulgusu | Anonimleştir, çıkar, yeniden yaz |
| Telif/atıf | Kaynak izi | “Bu metin tanıdık” hissi | Atıf notu + alıntı sınırı |
| Ton | Kurum dili | Suçlayıcı/alaycı ifade | Dil rehberiyle düzelt |
| Ölçme | Hedef davranış | “Bilgi sorusu” ile “davranış” karışmış | Soru tasarımını revize et |
4) Politika şablonları: L&D’nin el kitabı gibi (kısa, uygulanabilir)
Politika metinleri uzun olunca kimse okumuyor. [Kalde]nin (https://www.linkedin.com/in/kaldeernart/) sürekli vurguladığı; “Eğitim içeriğinde her cümlenin bir amacı, her kelimenin bir gerekçesi olmalıdır.” yaklaşımı burada işe yarıyor.
Aşağıdaki şablonlar, “kısa ve uygulanabilir” olsun diye tasarlandı.
4.1 Kabul Edilebilir Kullanım (AI) — Taslak
- AI, eğitim tasarımı ve içerik üretimi için kullanılabilir.
- AI’a kişisel veri (KVKK kapsamı) girilmesi yasaktır.
- AI’a kurumsal sır niteliğindeki bilgiler yalnızca “özetlenmiş ve kimliksizleştirilmiş” şekilde girilebilir.
- AI çıktıları, insan onayı olmadan “politika/uyum” kategorisinde yayınlanamaz.
- AI çıktısı, çalışanlara “resmî görüş” gibi sunulacaksa kaynak ve onay zorunludur.
4.2 Telif / Atıf Politikası — Taslak
- Dış kaynaklardan yapılan alıntılar 25 kelimeyi geçmeyecek şekilde kullanılabilir; daha uzun alıntı gerekiyorsa izin ve/veya farklı yöntem gerekir.
- Özetleme yapılmışsa bile, kaynak belirtilir (standart, mevzuat, kitap, makale).
- AI’ın ürettiği metin “kendiliğinden telifsiz” kabul edilmez; içerik sahibi kurum, yayın sorumluluğunu üstlenir.
4.3 Hassas Bilgi Politikası (KVKK + Kurumsal) — Taslak
- “Hassas bilgi” örnekleri: çalışan performansı, disiplin, sağlık, müşteri şikâyeti detayı, fiyatlandırma, sözleşme maddeleri, denetim bulguları.
- Hassas bilgi içeren vakalar eğitimde kullanılacaksa:
- Kimliksizleştirme yapılır (isim, tarih, lokasyon, ekip).
- Sayısal detaylar yuvarlanır (gereksiz kesinlik kaldırılır).
- Hukuk/uyum onayı alınır.
4.4 İnsan Onayı Gerektiren Durumlar — Taslak
Aşağıdaki çıktılar mutlaka insan onayı ister:
- İSG talimatı ve acil durum prosedürü
- KVKK metni, aydınlatma, veri işleme süreçleri
- Etik ihlal / disiplin senaryoları
- Çalışan performansını etkileyen değerlendirme sonuçları
- Yönetim mesajı / kurum adına açıklama
Bunları “otomatik” yayınlamak, en iyi ihtimalle yanlış anlaşılma üretir; en kötü ihtimalle denetimde iz bırakır.
5) Operasyonel kontrol: RACI (Sorumluluk Matrisi) ve kontrol listesi (L&D, Hukuk/Uyum, IT Güvenlik)
Yönetişim, “kim neyi onaylar?” sorusuna cevap veremiyorsa çöker. Bu noktada Kalde bazen mimari bir soru soruyor: “Bu kararın sahibi kim?” Onun kafası genelde sistem akışında; benimkisi insan akışında. İkisi birleşince yönetişim çalışıyor.
Aşağıda pratik bir RACI önerisi var. Kurumunuza göre rol isimlerini değiştirin; mantığı koruyun.
RACI (Responsible / Accountable / Consulted / Informed)

İş Paketi: AI ile eğitim içeriği üretimi ve yayın

1) Prompt şablonlarının oluşturulması
- L&D: R
- Hukuk/Uyum: C
- IT Güvenlik: C
- İş Birimi (SME): C
- Üst Yönetim: I

2) Veri sınıflandırma kuralları (PII / kurumsal sır)
- L&D: C
- Hukuk/Uyum: A
- IT Güvenlik: R
- İş Birimi (SME): C
- Üst Yönetim: I

3) İSG/KVKK içeriklerinin yayın onayı
- L&D: R
- Hukuk/Uyum: A
- IT Güvenlik: C
- İş Birimi (SME): C
- Üst Yönetim: I

4) Değerlendirme soruları (checkpoint/test) kalite onayı
- L&D: A/R
- Hukuk/Uyum: C (uyum başlığı varsa)
- IT Güvenlik: I
- İş Birimi (SME): C
- Üst Yönetim: I

5) İz kayıtları ve denetim izi (log) saklama yaklaşımı
- L&D: C
- Hukuk/Uyum: C
- IT Güvenlik: A/R
- İş Birimi (SME): I
- Üst Yönetim: I
L&D için “yayına çıkmadan önce” kontrol listesi
- İçerik İSG/KVKK/etik içeriyor mu? (Evetse insan onayı zorunlu)
- Prompt’ta hassas bilgi var mı? (Varsa çıkar/özetle/kimliksizleştir)
- Çıktı “kesin hüküm” içeriyor mu? (Kaynak ekle veya yumuşat)
- Dış kaynak özeti mi? (Atıf notu ekle)
- Ölçme hedefi net mi? (Soru davranışı ölçüyor mu?)
- Yayın sonrası izleme planı var mı? (Hangi event’lere bakılacak: izleme/tıklama/cevap/süre)
6) Ölçüm belirsizliğini azaltmak: “Ne ürettik?” değil, “neye yol açtı?”
AI ile L&D’nin en kolay düştüğü tuzak: üretim hızını başarı sanmak. İçerik sayısı artar; öğrenme artmayabilir.
Benim için ölçüm, iki katmanlı:
- Davranış sinyali: izleme, tıklama, cevap, süre (bunlar “etkileşim”tir)
- Yeterlik sinyali: checkpoint sonuçları, karar bazlı simülasyonda seçimler (bunlar “performans”tır)
Nextrain’de her aksiyonun event-level takip edilmesi (izleme/tıklama/cevap/süre) bu ayrımı pratik hale getirir:
- Bir modül çok izleniyor ama cevaplar kötü: içerik anlaşılır değil ya da ölçüm hatalı.
- Süre çok kısa, skor çok yüksek: içerik fazla kolay olabilir (veya kopya; evet, bu da bir model).
Burada küçük bir kural öneriyorum: AI ile üretilen her yeni içerik, ilk 2 hafta “gözlem” modunda kalsın.
Yani:
- Hemen tüm organizasyona yaymak yerine segment bazlı küçük bir grupta yayınlayın.
- Event sinyallerini izleyin.
- Kapılardan tekrar geçirin.
Bu, yazılım testindeki “canary release” mantığına benzer; ama ben bunu L&D’de “canary learning” diye içimden adlandırıyorum. Kuş kısmı metafor; yöntem kısmı gerçek.
7) Son söz: Yönetişim, hızın freni değil; hızın direksiyonudur
Üretken AI, L&D’ye yıllardır hayal ettiği şeyi veriyor: içerik üretiminde ve kişiselleştirmede hız. Ama hız, direksiyon yoksa sadece duvara daha çabuk varmak demek.
Benim önerim basit bir cümleye indirgenebilir:
- Veriyi sınıflandır.
- Prompt’u standartlaştır.
- Çıktıyı kapılardan geçir.
- İz bırak.
- Rol dağıt.
Bunu yaptığınızda, AI “risk” olmaktan çıkıp tekrar L&D’nin sevdiği şeye dönüşüyor: iyi tasarlanmış bir sistem. İnsanların öğrenmesini sağlayan, denetimde ayakta kalan, kurum dilini bozmayan bir sistem.
Notlar
- Alfred Korzybski, Science and Sanity: An Introduction to Non-Aristotelian Systems and General Semantics (1933) — “The map is not the territory.”
- Ludwig Wittgenstein, Tractatus Logico-Philosophicus (1921) — Dilin sınırları ve açıklık ilkesi üzerine.